


Цією статтею ми починаємо те, що давно хотіли зробити: серію детальних розборів інструментів Jinero — що вони вміють, як влаштовані під капотом і як насправді з'являлися на світ, разом із підходами, які не вижили.
Почнемо з  «Розпізнавання шрифтів», і це не випадково. У цього інструмента найдовша історія розробки на сайті: він пережив три зовсім різні рушії, ми порівнювали кожен з іншими на однакових тестах, а закінчилося все тим, що ми навчили власну нейромережу. Якщо якийсь інструмент і заслуговує на перший допис із-за лаштунків, то саме цей.
Що вміє інструмент
Ви побачили шрифт, який вам сподобався, — на постері, скриншоті, фото вітрини — і хочете дізнатися, що це за шрифт. Ось і весь сценарій.
Ви завантажуєте зображення, обрізаєте ділянку з текстом — і розпізнавач повертає найсхожіші варіанти з нашого каталогу, де понад 26 000 родин шрифтів (55 000+ окремих накреслень). Кожен збіг має живий перегляд: введіть власне слово — і миттєво побачите його в кожному шрифті-кандидаті. Це найшвидший спосіб переконатися: «так, це він».
На три речі варто звернути увагу:
- Нічого не треба вводити. Не потрібно підказувати інструменту, що написано на зображенні. Він дивиться на форми літер, а не на слова.
- Він розуміє кирилицю. У сервісах визначення шрифтів підтримка кирилиці зазвичай менш помітна, гірше задокументована й працює менш стабільно. Нашу модель свідомо навчали й тестували і на латиниці, і на кирилиці — скриншот українського тексту розпізнається так само добре, як англійського.
- Безкоштовно й без реєстрації. Обрізали, розпізнали, завантажили шрифт, якщо він є в нашому каталозі.
Як це працює (простими словами)
Сучасне розпізнавання шрифтів не «читає» текст. Наш рушій перетворює обрізане зображення на компактний числовий відбиток — ембединг, вектор зі 128 чисел, що описує форми літер: контраст штрихів, їхні закінчення, пропорції, загальний каркас гарнітури.
Кожен шрифт у каталозі вже має власні відбитки — їх заздалегідь обчислено з чистих рендерів і збережено в індексі. Тож розпізнавання — це просто пошук за схожістю: відбиток вашого зображення порівнюється з індексом, і ви отримуєте найближчі родини. Найважча робота виконується один раз, офлайн, а ваш запит займає частку секунди.
Кілька практичних деталей, які довелося відшліфувати:
- Нормалізація «темне на світлому». Індекс побудовано з темного тексту на світлому тлі. Якщо ваш скриншот інвертований — світлий текст на темному сайті, — інструмент помічає це за краями обрізаної ділянки й інвертує зображення перед порівнянням.
- Один результат на родину. Жирне й звичайне накреслення однієї гарнітури не повинні займати в результатах два місця. Ми групуємо збіги за родинами й показуємо найсхожіше накреслення.
- Стійкість до справжніх скриншотів. Стиснене в JPEG, трохи розмите фото зовсім не схоже на бездоганний рендер шрифту. Модель спеціально навчали не зважати на цю різницю (докладніше — нижче).
Історія: три рушії й дві переробки
Спроба 1: рушій на ручних ознаках
Перша версія працювала так, як працював би типограф, якби він був скриптом: за допомогою OCR читала текст на зображенні, збільшувала обрізаний фрагмент моделлю суперроздільності (ESPCN), а тоді рендерила той самий текст кожним шрифтом-кандидатом і порівнювала зображення за вручну підібраними геометричними ознаками — профілями проєкцій, вимірами штрихів, — ще й з окремим етапом переранжування зверху.
І це працювало. Ну, майже. Її поховали дві проблеми:
- Швидкість. Рендеринг і порівняння тексту для тисяч шрифтів займали близько 55 секунд на запит. Для демо — прийнятно, для справжнього інструмента — боляче.
- Крихка схема «все або нічого». Точність top-1 становила 36% — і точність top-3 теж 36%. Якщо правильний шрифт не був найпершим результатом, його не було в списку взагалі. Не було корисного короткого списку «схожих варіантів», а це половина цінності такого інструмента.
До того ж усе залежало від того, чи правильно спрацює OCR. А стилізовані написи — саме ті, які люди найчастіше хочуть розпізнати, — OCR читає найгірше.
Спроба 2: готова нейромережа
Далі ми спробували готову CNN для класифікації шрифтів (EfficientNet-B3, яку стороння команда навчила на 3473 класах шрифтів). Вона обійшла наш рушій на ручних ознаках — 48% top-1, 60% top-3 — і працювала швидко.
Але фіксований класифікатор має жорстку стелю: він здатен назвати лише ті шрифти, на яких його навчили. Наш каталог був більшим за його список класів, щотижня ріс і містив кириличні родини, яких модель ніколи не бачила. Кожна нова партія шрифтів означала б перенавчання. Це не рушій, а бігова доріжка.
Спроба 3: власна навчена модель ембедингів
Тож ми навчили власну — компактну EfficientNet-B0, яка перетворює будь-яке зображення тексту на той самий відбиток зі 128 чисел. Її навчали методом metric learning на рендерах нашого власного каталогу — латиниці й кирилиці разом.
Головна хитрість була в навчальних даних. Ми не обмежилися чистими рендерами шрифтів — ми навмисно й нещадно їх псували: розмиття, шум, артефакти JPEG-стиснення, кольорове тло, легкий поворот. Модель засвоїла, що чіткий рендер із каталогу й посереднє фото тієї самої гарнітури на телефон мають давати той самий відбиток. Саме ця властивість — інваріантність до рендеру — і дає їй змогу працювати на справжніх скриншотах.
Така архітектура заодно розв'язала проблему бігової доріжки. Коли з'являються нові шрифти, ми нічого не перенавчаємо — просто рендеримо їх, обчислюємо відбитки наявною моделлю й додаємо в індекс. Каталог росте, а модель лишається та сама.
І остаточно розв'язала проблему швидкості. Оскільки вся важка робота — рендеринг каталогу й обчислення відбитків — відбувається офлайн, живий запит зводиться до одного прогону невеликої моделі та пошуку за схожістю. На нашому продакшн-сервері повний прохід рушія займає близько 200 мс (медіана ~195 мс на повторних запусках, лише CPU — без жодного GPU). Рушію v1 на ту саму роботу потрібно було ~55 секунд: тобто новий приблизно у 280 разів швидший, а точність top-3 при цьому майже подвоїлася.
Той самий розпізнавач доступний і через наш публічний  Fonts API (
POST /api/v1/fonts/recognize) — для розробників, які хочуть вбудувати визначення шрифтів у власні робочі процеси.
Результати
Ми протестували всі три рушії за однаковим протоколом: той самий набір шрифтів, ті самі зіпсовані вхідні зображення, схожі на скриншоти, точність на рівні родини.
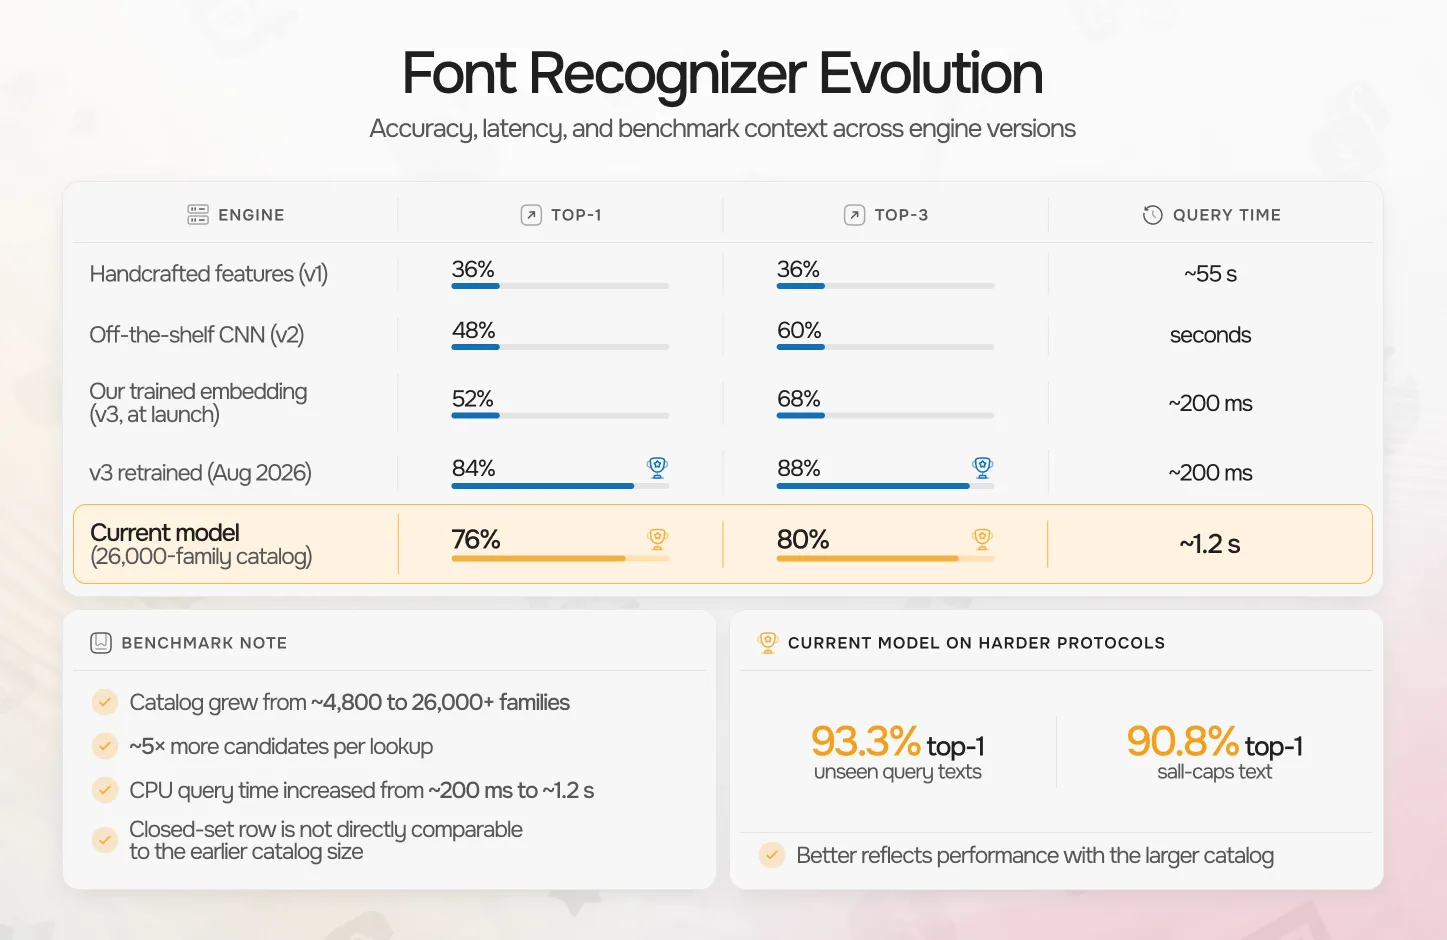
| Рушій | Top-1 | Top-3 | Час запиту |
|---|---|---|---|
| Ручні ознаки (v1) | 36% | 36% | ~55 с |
| Готова CNN (v2) | 48% | 60% | секунди |
| Наш навчений ембединг (v3, на старті) | 52% | 68% | ~200 мс |
| v3 після перенавчання (серпень 2026) | 84% | 88% | ~200 мс |
| Поточна модель (каталог на 26 000 родин) | 76% | 80% | ~1,2 с |
В останньому рядку змінилися дві речі, і обидві — свідомо. Каталог виріс приблизно з 4800 родин шрифтів до понад 26 000 — більш ніж уп'ятеро, — і ми перенавчили модель з нуля на всьому каталозі, взявши більшу мережу й вищу роздільність вхідних зображень. Тепер кожен пошук іде серед уп'ятеро більшої кількості кандидатів, а час запиту зріс із ~200 мс приблизно до 1,2 секунди — така ціна важчої моделі на CPU.
Точність у цьому рядку легко сприйняти як крок назад, тож тут потрібне застереження. Цей бенчмарк — закритий набір із 25 шрифтів, де один шрифт важить чотири відсоткові пункти, — а сам цей спільний набір узято з каталогу, який тепер уп'ятеро більший, тож два останні рядки вимірюють не одне й те саме завдання. На протоколах, які справді розрізняють ці дві моделі, — незнайомі тексти запитів, а дистракторами слугує весь каталог, — новіша модель далеко попереду: 93,3% top-1 проти 72,4% і 90,8% проти 61,3% на тексті великими літерами. Ці цифри — в епілозі нижче.
Що саме ми тестували?
Слушне запитання — цифри точності без протоколу нічого не означають. Тестовий набір — 25 родин шрифтів, які знають усі три рушії (це обмеження задав готовий класифікатор, що знає лише свій фіксований список класів). Для кожної родини ми рендерили зразок тексту й проганяли його через конвеєр, що імітує скриншот: зменшення й збільшення в 3 рази (як дрібний текст на екрані), легке розмиття, JPEG-стиснення з якістю 45 і шум сенсора, — а потім подавали ідентичні зіпсовані зображення всім трьом рушіям із фіксованим random seed. Точність рахується на рівні родини: прогноз вважається правильним, якщо названо правильну родину шрифтів, у будь-якому накресленні; top-3 зараховує правильну родину будь-де серед перших трьох результатів.
Зверніть увагу: ці цифри отримано на навмисно зіпсованих вхідних даних — бенчмарк імітує погані скриншоти, бо так буває в житті. Перенавчена модель майже не помічає цих спотворень: на нашому найскладнішому внутрішньому протоколі (незнайомі тексти запитів проти повного каталогу з 15 000 шрифтів) її точність top-1 однакова на чистих і зіпсованих зображеннях.
А показник top-3 важливіший, ніж здається: на практиці ви кидаєте оком на трьох кандидатів зі своїм текстом у перегляді й одразу обираєте потрібний. Рушій v1 такого взагалі не давав, а поточна модель приводить вас до відповіді майже дев'ять разів із десяти — навіть на поганих зображеннях.
Бонус, якого ми не планували: ті самі відбитки тепер живлять розділ «Схожі шрифти» на кожній сторінці шрифту в каталозі. Навчили одну модель — отримали дві функції.
Порівняння з іншими сервісами пошуку шрифтів
Визначення шрифтів — не нова ідея, і деякі відомі інструменти справляються з цим добре. Якщо ви шукаєте шрифт, ось чесна мапа того, що є:
- WhatTheFont (MyFonts) — мабуть, найвідоміший, за ним стоїть величезна комерційна бібліотека. Чудове покриття латиниці; результати, звісно, схиляють до шрифтів, які можна купити на MyFonts.
- WhatFontIs — величезний індекс, у якому змішано безкоштовні й комерційні шрифти, і сильний пошук альтернатив. Є безкоштовний тариф, а необмежений пошук, перегляд із власним текстом і розширені фільтри входять у PRO.
- Fontspring Matcherator — охайний, швидкий, без реєстрації, з фільтрацією за тегами OpenType-функцій. Орієнтований на комерційний каталог Fontspring.
- Font Squirrel Matcherator — рушій тієї самої родини, що й у Fontspring, але орієнтований на бібліотеку Font Squirrel зі шрифтами, безкоштовними для комерційного використання.
- Identifont — ветеран жанру: жодного завантаження зображень, лише анкета про форми літер («чи прямий хвостик у літери Q?»). Повільніше, але напрочуд ефективно, коли все, що у вас є, — це спогад про шрифт.
А де тут наш? Серед них його вирізняють три речі:
- Кирилиця на рівних із латиницею — на ній навчали, її індексували, на ній тестували. Для українського тексту це різниця між «працює» і «вгадує».
- Миттєвий перегляд із вашим текстом — кожен кандидат одразу перемальовується з будь-яким словом, яке ви введете, і це за лічені секунди перетворює «трійку кандидатів» на «відповідь».
- Безкоштовно, без акаунта й з можливістю завантажити — збіги ведуть просто на сторінки шрифтів у нашому каталозі, де самі шрифти можна безкоштовно завантажити й використовувати.
Ми не вдаватимемо, що покриваємо більше, ніж комерційна бібліотека MyFonts: якщо ви шукаєте ліцензовану корпоративну гарнітуру, WhatTheFont може назвати точний комерційний шрифт, а ми покажемо його найближчих родичів. Різні каталоги — різні сильні сторони. Але для безкоштовних шрифтів і для всього кириличного ми виставили б наш розпізнавач проти будь-кого з них.
Епілог: потім ми збільшили каталог у 7 разів — і знову перенавчили модель
Цей допис був майже готовий, коли ми зробили те, що знову змінило цифри. За один тиждень ми розширили каталог із ~5000 до понад 26 000 опублікованих родин (34 500 загалом) і перенавчили модель з нуля на всій колекції: більша базова мережа (EfficientNet-B2), вища роздільність (288 px), повне покриття гліфів, зокрема розширеної латиниці й кирилиці, вибірка з перевагою великих літер і вибірка значень осей варіативних шрифтів за їхніми справжніми таблицями fvar.
На протоколі оцінювання з 900 родин нова модель визначає правильну родину у 93,3% випадків (98,7% top-3), тоді як попередня впоралася на 72,4%, — а на постерному тексті великими літерами, найскладнішому реальному випадку, точність top-1 підскочила з 61,3% до 90,8%. Розпізнавач, яким ви користуєтеся сьогодні, працює саме на цій моделі, з індексом на 278 000 рендерів і етапом переранжування з OCR, що розрізняє майже ідентичні гарнітури саме на вашому тексті.
Від рукотворного скрипта, що думав 55 секунд і влучав лише в третині випадків, до власноруч навченої нейромережі, яка приблизно за секунду розпізнає шрифт серед 26 000 родин, — ось і вся історія на сьогодні. І це не останній розділ.
Що далі
Розпізнавач не застиг на місці. Його покращують дві речі, кожна у своєму ритмі:
- Каталог росте щотижня — і завдяки архітектурі на ембедингах кожна нова родина шрифтів стає розпізнаваною, щойно для неї обчислено відбиток і її додано в індекс. Без перенавчання й без очікування наступної версії моделі.
- Сама модель періодично оновлюється. Що більший каталог, то більше в нас навчальних даних — кожна нова родина стає матеріалом для наступного навчання. У планах: навчання на вищій роздільності, щоб тонше розрізняти декоративні й рукописні шрифти; підтримка інших систем письма, крім латиниці й кирилиці (насамперед грецької та в'єтнамської); і запити з кількох фрагментів — розпізнавання за двома-трьома зразками того самого шрифту одночасно з усередненням відбитків для стабільнішого результату.
Цифри точності в цьому дописі — знімок поточного стану, а не стеля.
Спробуйте
«Розпізнавання шрифтів» уже працює на jinero.online/uk/fonts/recognizer — безкоштовно, без реєстрації, для латиниці й кирилиці. Зробіть скриншот шрифту, який давно вас цікавить, і подивіться, що знайде розпізнавач.
Це перший допис у нашій серії детальних розборів інструментів. Далі ми візьмемо ще один інструмент із колекції й так само розберемо його по гвинтиках. Якщо хочете, щоб ми почали з якогось конкретного, — напишіть нам.
Коментарі 0
Увійдіть, щоб залишити перший коментар.