


Mit diesem Artikel starten wir etwas, das wir schon länger vorhatten: eine Reihe ausführlicher Blicke auf die Tools von Jinero – was sie können, wie sie unter der Haube funktionieren und die ehrliche Geschichte ihrer Entstehung, einschließlich der Ansätze, die es nicht geschafft haben.
Wir beginnen mit dem Tool  Schriftart erkennen – und das nicht zufällig. Kein anderes Tool auf der Website hat eine so lange Entwicklungsgeschichte: Es hat drei völlig unterschiedliche Engines durchlaufen, wir haben jede davon gegen die anderen getestet, und am Ende stand ein selbst trainiertes neuronales Netz. Wenn ein Tool den ersten Blick hinter die Kulissen verdient, dann dieses.
Was das Tool kann
Du hast eine Schrift gesehen, die dir gefällt – auf einem Plakat, einem Screenshot, dem Foto einer Ladenfront – und willst wissen, welche es ist. Genau dafür ist das Tool da.
Du lädst das Bild hoch, schneidest den Bereich mit dem Text zu, und die Schrifterkennung liefert die ähnlichsten Treffer aus unserem Katalog mit über 26.000 Schriftfamilien (55.000+ einzelne Schnitte). Zu jedem Treffer gibt es eine Live-Vorschau: Tippe dein eigenes Wort ein und sieh es sofort in jeder Kandidatenschrift – der schnellste Weg zu „Ja, das ist sie“.
Drei Dinge sind besonders erwähnenswert:
- Kein Abtippen nötig. Du musst dem Tool nicht sagen, was im Bild steht. Es schaut auf Buchstabenformen, nicht auf Wörter.
- Es kann Kyrillisch. Bei Tools zur Schriftarterkennung ist die Unterstützung für Kyrillisch oft weniger sichtbar, schlechter dokumentiert und weniger zuverlässig. Unser Modell wurde gezielt auf Lateinisch und Kyrillisch trainiert und getestet – ein Screenshot mit ukrainischem Text funktioniert genauso gut wie einer mit englischem.
- Kostenlos und ohne Anmeldung. Zuschneiden, erkennen und die Schrift herunterladen, wenn sie in unserem Katalog ist.
So funktioniert’s (die verständliche Version)
Moderne Schrifterkennung „liest“ den Text gar nicht. Unsere Engine wandelt den zugeschnittenen Ausschnitt in einen kompakten numerischen Fingerabdruck um – ein Embedding, also einen Vektor aus 128 Zahlen, der die Formen der Buchstaben beschreibt: Strichkontrast, Endstriche, Proportionen, das Grundgerüst der Schrift.
Jede Schrift im Katalog hat bereits ihre eigenen Fingerabdrücke – vorab aus sauberen Renderings berechnet und in einem Index gespeichert. Die Erkennung ist dann nur noch eine Ähnlichkeitssuche: Der Fingerabdruck deines Bildes wird mit dem Index verglichen, und die nächstgelegenen Familien werden zurückgegeben. Die Schwerarbeit passiert einmal, offline; deine Anfrage dauert nur den Bruchteil einer Sekunde.
Ein paar praktische Details mussten wir dabei richtig hinbekommen:
- Normalisierung auf dunkel auf hell. Der Index besteht aus dunklem Text auf hellem Hintergrund. Ist dein Screenshot invertiert – heller Text auf einer dunklen Website –, erkennt das Tool das am Rand des Ausschnitts und kehrt ihn vor dem Abgleich um.
- Ein Ergebnis pro Familie. Bold und Regular derselben Schrift sollen die Ergebnisse nicht als zwei Einträge verstopfen. Wir fassen auf Familienebene zusammen und zeigen den am besten passenden Schnitt.
- Robust gegenüber echten Screenshots. Ein JPEG-komprimiertes, leicht unscharfes Foto sieht ganz anders aus als ein makelloses Rendering der Schrift. Das Modell wurde gezielt darauf trainiert, diesen Unterschied zu ignorieren (mehr dazu weiter unten).
Die Geschichte: drei Engines, zwei Neuanfänge
Versuch 1: die handgebaute Engine
Die erste Version arbeitete so, wie es ein Typograf tun würde – wäre er ein Skript: Sie las den Text in deinem Bild per OCR, skalierte den Ausschnitt mit einem Super-Resolution-Modell (ESPCN) hoch, renderte dann genau diesen Text in jeder Kandidatenschrift und verglich die Bilder anhand handgebauter geometrischer Merkmale – Projektionsprofile, Strichmessungen – mit einem zusätzlichen Re-Ranking-Durchgang.
Es funktionierte. Irgendwie. Zwei Probleme haben es zu Fall gebracht:
- Geschwindigkeit. Text in Tausenden Schriften zu rendern und zu vergleichen, dauerte rund 55 Sekunden pro Anfrage. Für eine Demo akzeptabel, für ein echtes Tool eine Qual.
- Ein fragiles „Alles oder nichts“-Muster. Die Top-1-Genauigkeit lag bei 36 % – und die Top-3-Genauigkeit ebenfalls bei 36 %. War die richtige Schrift nicht das allererste Ergebnis, stand sie gar nicht in der Liste. Es gab keine brauchbare Shortlist mit „ähnlichen Treffern“ – und die macht die Hälfte des Werts eines solchen Tools aus.
Außerdem hing alles davon ab, dass die OCR richtig lag. Und stilisierte Schriftzüge – genau die, die man am häufigsten bestimmen möchte – sind genau das, woran OCR am ehesten scheitert.
Versuch 2: ein fertiges neuronales Netz
Als Nächstes probierten wir ein fertiges CNN zur Schriftklassifikation (ein EfficientNet-B3, das ein Drittanbieter auf 3.473 Schriftklassen trainiert hatte). Es schlug unsere handgebaute Engine – 48 % Top-1, 60 % Top-3 – und war schnell.
Doch ein fester Klassifikator hat eine harte Obergrenze: Er kann immer nur die Schriften benennen, auf die er trainiert wurde. Unser Katalog war größer als seine Klassenliste, wuchs jede Woche und enthielt kyrillische Familien, die das Modell nie gesehen hatte. Jede neue Ladung Schriften hätte ein neues Training bedeutet. Das ist keine Engine, das ist ein Hamsterrad.
Versuch 3: unser eigenes trainiertes Embedding-Modell
Also haben wir ein eigenes trainiert – ein kompaktes EfficientNet-B0, das jedes Textbild auf diesen Fingerabdruck aus 128 Zahlen abbildet, trainiert per Metric Learning auf Renderings unseres eigenen Katalogs, Lateinisch und Kyrillisch gemeinsam.
Der entscheidende Trick lag in den Trainingsdaten. Wir haben es nicht nur mit sauberen Renderings trainiert, sondern diese gezielt verschlechtert: Unschärfe, Rauschen, JPEG-Kompressionsartefakte, getönte Hintergründe, leichte Drehung. Das Modell lernte, dass ein gestochen scharfes Katalog-Rendering und ein mittelmäßiges Handyfoto derselben Schrift auf denselben Fingerabdruck führen sollen. Genau diese Eigenschaft – Render-Invarianz – sorgt dafür, dass es bei echten Screenshots funktioniert.
Die Architektur löste auch das Hamsterrad-Problem. Kommen neue Schriften hinzu, trainieren wir nichts neu – wir rendern sie einfach, berechnen ihre Fingerabdrücke mit dem vorhandenen Modell und nehmen sie in den Index auf. Der Katalog wächst, das Modell bleibt.
Und sie löste das Geschwindigkeitsproblem endgültig. Weil die ganze Schwerarbeit – den Katalog rendern und seine Fingerabdrücke berechnen – offline passiert, ist eine Live-Anfrage nur noch eine Inferenz mit einem kleinen Modell plus eine Ähnlichkeitssuche. Auf unserer Produktionshardware dauert ein kompletter Durchlauf der Engine etwa 200 ms (Median ~195 ms über wiederholte Läufe, nur CPU – keine GPU im Spiel). Die v1-Engine brauchte für dieselbe Aufgabe ~55 Sekunden: rund 280× schneller, bei fast doppelter Top-3-Genauigkeit.
Dieselbe Erkennung steht auch über unsere öffentliche  Fonts API (
POST /api/v1/fonts/recognize) bereit – für Entwickler, die Schriftarterkennung in ihre eigenen Workflows einbauen wollen.
Die Ergebnisse
Wir haben alle drei Engines nach einem identischen Protokoll getestet: dieselben Schriften, dieselben verschlechterten, screenshotähnlichen Eingaben, Genauigkeit auf Familienebene.
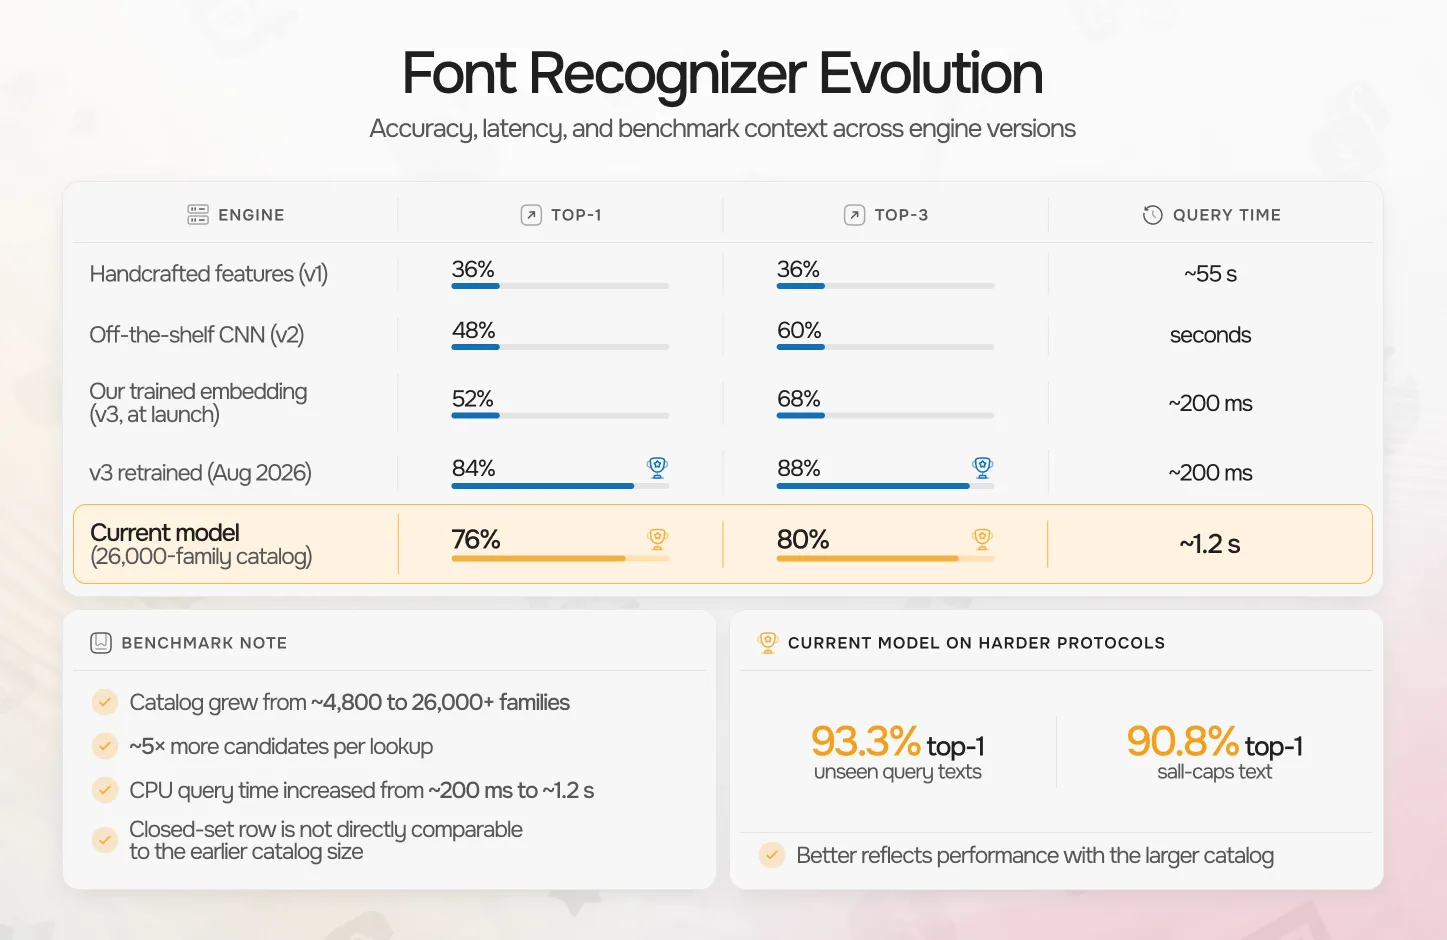
| Engine | Top-1 | Top-3 | Anfragezeit |
|---|---|---|---|
| Handgebaute Merkmale (v1) | 36 % | 36 % | ~55 s |
| Fertiges CNN (v2) | 48 % | 60 % | Sekunden |
| Unser trainiertes Embedding (v3, zum Start) | 52 % | 68 % | ~200 ms |
| v3 neu trainiert (Aug. 2026) | 84 % | 88 % | ~200 ms |
| Aktuelles Modell (Katalog mit 26.000 Familien) | 76 % | 80 % | ~1,2 s |
In der letzten Zeile hat sich zweierlei geändert, und beides war Absicht. Der Katalog wuchs von rund 4.800 auf über 26.000 Schriftfamilien – mehr als das Fünffache –, und wir haben auf dem gesamten Bestand von Grund auf neu trainiert, mit einem größeren Netz und höherer Eingabeauflösung. Jede Suche läuft jetzt gegen fünfmal so viele Kandidaten, und die Anfragezeit stieg von ~200 ms auf etwa 1,2 Sekunden: der Preis für ein schwereres Modell auf einer CPU.
Die Genauigkeitswerte in dieser Zeile lassen sich leicht als Rückschritt missverstehen, deshalb ein Hinweis dazu. Dieser Benchmark ist eine geschlossene Menge von 25 Schriften, in der eine einzige Schrift vier Prozentpunkte ausmacht – und diese gemeinsame Menge stammt selbst aus einem Katalog, der inzwischen fünfmal größer ist. Die letzten beiden Zeilen messen also nicht dieselbe Aufgabe. In den Protokollen, die die beiden Modelle tatsächlich auseinanderhalten können – unbekannte Suchtexte, der gesamte Katalog als Störfaktor –, liegt das neuere weit vorn: 93,3 % Top-1 gegenüber 72,4 % und 90,8 % gegenüber 61,3 % bei Text in Großbuchstaben. Diese Zahlen findest du im Epilog weiter unten.
Was genau haben wir getestet?
Eine berechtigte Frage – Genauigkeitswerte bedeuten ohne Protokoll nichts. Das Testset besteht aus 25 Schriftfamilien, die alle drei Engines abdecken (eine Einschränkung durch den fertigen Klassifikator, der nur seine feste Klassenliste kennt). Für jede Familie haben wir eine Textprobe gerendert und durch eine Pipeline geschickt, die schlechte Screenshots nachahmt: 3× verkleinern und wieder vergrößern (simuliert kleinen Bildschirmtext), leichte Unschärfe, JPEG-Kompression mit Qualität 45 und Sensorrauschen – und dann allen drei Engines mit festem Zufalls-Seed die identischen verschlechterten Bilder gegeben. Gemessen wird auf Familienebene: Eine Vorhersage gilt als richtig, wenn sie die richtige Schriftfamilie nennt, egal welchen Schnitt; bei Top-3 zählt die richtige Familie irgendwo unter den ersten drei Ergebnissen.
Beachte, dass diese Zahlen aus absichtlich verschlechterten Eingaben stammen – der Benchmark simuliert schlechte Screenshots, denn so sieht die Realität aus. Das neu trainierte Modell bemerkt die Verschlechterung kaum: In unserem härtesten internen Protokoll (unbekannte Suchtexte gegen den vollständigen Katalog mit 15.000 Schriften) ist seine Top-1-Genauigkeit bei sauberen und verschlechterten Eingaben identisch.
Und der Top-3-Wert ist wichtiger, als er aussieht: In der Praxis wirfst du mit deinem eigenen Vorschautext einen Blick auf drei Kandidaten und erkennst sofort den richtigen. Die v1-Engine konnte das überhaupt nicht bieten – das aktuelle Modell bringt dich in fast neun von zehn Fällen dorthin, selbst bei hässlichen Eingaben.
Ein ungeplanter Bonus: Dieselben Fingerabdrücke stecken jetzt hinter dem Bereich „Ähnliche Schriftarten“ auf jeder Schriftart-Seite im Katalog. Ein Modell trainiert, zwei Funktionen bekommen.
Im Vergleich mit anderen Tools zur Schrifterkennung
Schriftarterkennung ist keine neue Idee, und einige etablierte Tools machen das gut. Wenn du auf der Suche nach einer Schrift bist, hier ein ehrlicher Überblick:
- WhatTheFont (MyFonts) – wahrscheinlich das bekannteste, gestützt auf eine riesige kommerzielle Bibliothek. Sehr gute Abdeckung lateinischer Schriften; die Ergebnisse führen naturgemäß zu Schriften, die du bei MyFonts kaufen kannst.
- WhatFontIs – ein riesiger Index aus kostenlosen und kommerziellen Schriften, stark beim Finden von Alternativen. Es gibt eine kostenlose Stufe; unbegrenzte Suchen, eigene Vorschauen und erweiterte Filter gehören zu PRO.
- Fontspring Matcherator – aufgeräumt, schnell, ohne Anmeldung, mit Filtern nach OpenType-Features. Ausgerichtet auf den kommerziellen Fontspring-Katalog.
- Font Squirrel Matcherator – dieselbe Engine-Familie wie bei Fontspring, ausgerichtet auf die Bibliothek von Font Squirrel mit Schriften, die auch kommerziell kostenlos nutzbar sind.
- Identifont – der Veteran des Genres: kein Bild-Upload, nur ein Fragebogen zu Buchstabenformen („Hat das Q einen geraden Schwanz?“). Langsamer, aber überraschend wirksam, wenn du die Schrift nur noch aus der Erinnerung kennst.
Und wo steht unser Tool? Drei Dinge heben es in dieser Runde ab:
- Kyrillisch als vollwertiges Schriftsystem – damit trainiert, damit indexiert, damit getestet. Bei ukrainischem Text ist das der Unterschied zwischen „funktioniert“ und „rät“.
- Sofortige Vorschau mit deinem Text – jeder Kandidat wird live mit dem Wort neu gerendert, das du eintippst. So werden aus „Top-3-Kandidaten“ in Sekunden „die Antwort“.
- Kostenlos, ohne Konto und zum Herunterladen – Treffer führen direkt zu den Schriftart-Seiten in unserem Katalog, wo du die Schriften selbst kostenlos herunterladen und nutzen kannst.
Wir behaupten nicht, mehr abzudecken als die kommerzielle Bibliothek von MyFonts – wenn du eine lizenzierte Unternehmensschrift bestimmen willst, nennt WhatTheFont vielleicht genau die Kaufschrift, während wir dir ihre nächsten Verwandten zeigen. Unterschiedliche Kataloge, unterschiedliche Stärken. Bei kostenlosen Schriften und bei allem Kyrillischen nehmen wir es mit jedem dieser Tools auf.
Epilog: Dann wurde der Katalog 7× größer – und wir haben noch einmal neu trainiert
Dieser Beitrag war fast fertig, als wir etwas taten, das die Zahlen noch einmal veränderte. Innerhalb einer einzigen Woche haben wir den Katalog von ~5.000 auf über 26.000 veröffentlichte Familien (insgesamt 34.500) erweitert und das Modell auf der gesamten Sammlung von Grund auf neu trainiert – mit größerem Backbone (EfficientNet-B2), höherer Auflösung (288 px), vollständiger Glyphenabdeckung einschließlich erweitertem Lateinisch und Kyrillisch, Sampling mit Schwerpunkt auf Großbuchstaben und einem Sampling der Achsen von Variable Fonts anhand ihrer echten fvar-Tabellen.
In einem Evaluationsprotokoll mit 900 Familien erkennt das neue Modell die richtige Familie in 93,3 % der Fälle (98,7 % Top-3), wo das vorherige auf 72,4 % kam – und bei Plakattext in Großbuchstaben, dem schwierigsten Fall aus der Praxis, sprang es bei Top-1 von 61,3 % auf 90,8 %. Die Schrifterkennung, die du heute nutzt, läuft mit diesem Modell, gestützt auf einen Index aus 278.000 Renderings und eine OCR-gestützte Rerank-Stufe, die nahezu identische Schriften anhand genau deines Textes auseinanderhält.
Von einem handgebauten Skript, das 55 Sekunden brauchte und in einem Drittel der Fälle richtig lag, zu einem selbst trainierten neuronalen Netz, das in etwa einer Sekunde unter 26.000 Familien die richtige erkennt – das ist die Geschichte bis heute. Das letzte Kapitel ist es nicht.
Wie es weitergeht
Die Schrifterkennung steht nicht still. Zwei Dinge verbessern sie laufend, in zwei unterschiedlichen Rhythmen:
- Der Katalog wächst jede Woche – und dank der Embedding-Architektur wird jede neue Schriftfamilie erkennbar, sobald ihr Fingerabdruck berechnet und sie in den Index aufgenommen ist. Kein neues Training, kein Warten auf die nächste Modellversion.
- Das Modell selbst bekommt regelmäßig Upgrades. Mit dem Katalog wachsen auch unsere Trainingsdaten – jede neue Familie ist mehr Material für den nächsten Trainingslauf. Auf der Roadmap: Training mit höherer Auflösung, um dekorative Schriften und Schreibschriften feiner zu unterscheiden, Unterstützung weiterer Schriftsysteme über Lateinisch und Kyrillisch hinaus (zuerst Griechisch und Vietnamesisch) und Anfragen mit mehreren Ausschnitten – Erkennung anhand von zwei oder drei Proben derselben Schrift gleichzeitig, mit gemittelten Fingerabdrücken für einen stabileren Treffer.
Die Genauigkeitswerte in diesem Beitrag sind eine Momentaufnahme, keine Obergrenze.
Probier es aus
Die Schrifterkennung ist live unter jinero.online/de/fonts/recognizer – kostenlos, ohne Anmeldung, für Lateinisch und Kyrillisch. Mach einen Screenshot von einer Schrift, die dich schon länger interessiert, und schau, was herauskommt.
Das ist der erste Beitrag unserer Reihe, in der wir Tools ausführlich unter die Lupe nehmen. Als Nächstes nehmen wir uns ein weiteres Tool aus der Sammlung vor und zerlegen es auf dieselbe Weise. Gibt es eines, über das wir zuerst schreiben sollen? Sag es uns.
Kommentare 0
Melde dich an, um den ersten Kommentar zu schreiben.