


Com este artigo começamos algo que queríamos fazer há tempos: uma série de análises detalhadas das ferramentas do Jinero — o que elas fazem, como funcionam por dentro e a história sincera de como surgiram, incluindo as abordagens que não sobreviveram.
Começamos pelo  Identificador de fontes, e não por acaso. É a ferramenta com a história de desenvolvimento mais longa do site: ela passou por três motores completamente diferentes, comparamos cada um deles com os outros em benchmarks, e tudo terminou com o treinamento da nossa própria rede neural. Se alguma ferramenta merece o primeiro post de bastidores, é esta.
O que ela faz
Você viu uma fonte de que gostou — em um pôster, em uma captura de tela, na foto de uma fachada de loja — e quer saber qual é. Esse é todo o caso de uso.
Você envia a imagem, recorta a área com o texto, e o Identificador de fontes retorna as correspondências mais próximas do nosso catálogo de mais de 26.000 famílias de fontes (55.000+ estilos individuais). Cada correspondência vem com uma prévia ao vivo, então você pode digitar a sua própria palavra e vê-la renderizada na hora em todas as fontes candidatas — o jeito mais rápido de confirmar “sim, é essa”.
Três pontos que merecem destaque:
- Não é preciso digitar nada. Você não precisa dizer à ferramenta o que está escrito na imagem. Ela olha para as formas das letras, não para as palavras.
- Ela lê cirílico. O suporte ao cirílico costuma ser menos visível, menos documentado e menos consistente entre as ferramentas de identificação de fontes. O nosso modelo foi explicitamente treinado e avaliado tanto no alfabeto latino quanto no cirílico — uma captura de tela com texto em ucraniano funciona tão bem quanto uma em inglês.
- É grátis e sem cadastro. Recorte, identifique e baixe a fonte, se ela estiver no nosso catálogo.
Como funciona (a versão acessível)
O reconhecimento moderno de fontes não consiste em “ler” o texto. O nosso motor converte a imagem recortada em uma impressão digital numérica compacta — um embedding, um vetor de 128 números que descreve as formas das letras: o contraste do traço, os terminais, as proporções, o esqueleto geral da fonte.
Cada fonte do catálogo já tem as suas próprias impressões digitais, pré-calculadas a partir de renderizações limpas e armazenadas em um índice. O reconhecimento, então, é apenas uma busca por similaridade: comparar a impressão digital da sua imagem com o índice e retornar as famílias mais próximas. O trabalho pesado acontece uma vez, offline; a sua consulta leva uma fração de segundo.
Alguns detalhes práticos que precisávamos acertar:
- Normalização para escuro sobre claro. O índice é construído com texto escuro sobre fundo claro. Se a sua captura de tela estiver invertida — texto claro em um site escuro —, a ferramenta detecta isso pela borda do recorte e inverte a imagem antes da comparação.
- Um resultado por família. O negrito e o regular da mesma fonte não devem lotar os resultados como duas entradas. Agrupamos tudo no nível da família e mostramos o estilo que melhor corresponde.
- Robustez a capturas de tela reais. Uma foto comprimida em JPEG e um pouco desfocada não se parece em nada com uma renderização impecável da fonte. O modelo foi treinado especificamente para ignorar essa diferença (mais sobre isso abaixo).
A história: três motores, duas reescritas
Tentativa 1: o motor artesanal
A primeira versão funcionava como um tipógrafo trabalharia, se um tipógrafo fosse um script: ela usava OCR para ler o texto da sua imagem, ampliava o recorte com um modelo de super-resolução (ESPCN), depois renderizava esse mesmo texto em cada fonte candidata e comparava as imagens usando características geométricas definidas à mão — perfis de projeção, medidas de traço —, com uma etapa de reclassificação por cima.
Funcionava. Mais ou menos. Dois problemas acabaram com ela:
- Velocidade. Renderizar e comparar o texto em milhares de fontes levava cerca de 55 segundos por consulta. Aceitável para uma demo, sofrível para uma ferramenta de verdade.
- Um padrão frágil de “tudo ou nada”. A precisão top-1 era de 36% — e a precisão top-3 também era de 36%. Se a fonte certa não fosse o primeiríssimo resultado, ela simplesmente não estava na lista. Não havia uma lista curta e útil de “correspondências próximas”, que é metade do valor de uma ferramenta como esta.
Ela também dependia de o OCR acertar. Letreiros estilizados — exatamente o tipo que as pessoas mais querem identificar — são justamente aquilo em que o OCR mais erra.
Tentativa 2: uma rede neural pronta
Em seguida, testamos uma CNN pronta de classificação de fontes (uma EfficientNet-B3 treinada por terceiros em 3.473 classes de fontes). Ela superou o nosso motor artesanal — 48% no top-1, 60% no top-3 — e era rápida.
Mas um classificador fixo tem um teto rígido: ele só consegue nomear as fontes com que foi treinado. O nosso catálogo era maior que a lista de classes dele, crescia toda semana e incluía famílias cirílicas que o modelo nunca tinha visto. Cada novo lote de fontes significaria retreinar. Isso não é um motor, é uma esteira.
Tentativa 3: o nosso próprio modelo de embeddings
Então treinamos o nosso — uma EfficientNet-B0 compacta que mapeia qualquer imagem de texto para aquela impressão digital de 128 números, treinada com aprendizado métrico em renderizações do nosso próprio catálogo, latino e cirílico juntos.
O truque principal estava nos dados de treinamento. Não o treinamos apenas com renderizações limpas de fontes — nós as degradamos agressivamente: desfoque, ruído, artefatos de compressão JPEG, fundos coloridos, leve rotação. O modelo aprendeu que uma renderização nítida do catálogo e uma foto medíocre de celular da mesma fonte devem chegar à mesma impressão digital. Essa propriedade — a invariância à renderização — é o que faz o modelo funcionar com capturas de tela reais.
A arquitetura também resolveu o problema da esteira. Quando chegam fontes novas, não retreinamos nada — apenas as renderizamos, calculamos as impressões digitais delas com o modelo existente e as adicionamos ao índice. O catálogo cresce; o modelo continua o mesmo.
E ela resolveu de vez o problema da velocidade. Como todo o trabalho pesado — renderizar o catálogo e calcular as impressões digitais — acontece offline, uma consulta ao vivo é apenas uma inferência de um modelo pequeno mais uma busca por similaridade. No nosso hardware de produção, a passagem completa pelo motor leva cerca de 200 ms (mediana de ~195 ms em execuções repetidas, só CPU — sem GPU). O motor v1 precisava de ~55 segundos para o mesmo trabalho: ou seja, ficou cerca de 280× mais rápido, e ainda quase dobrou a precisão top-3.
O mesmo identificador também está disponível na nossa  Fonts API pública (
POST /api/v1/fonts/recognize) para desenvolvedores que querem identificar fontes nos seus próprios fluxos de trabalho.
Os resultados
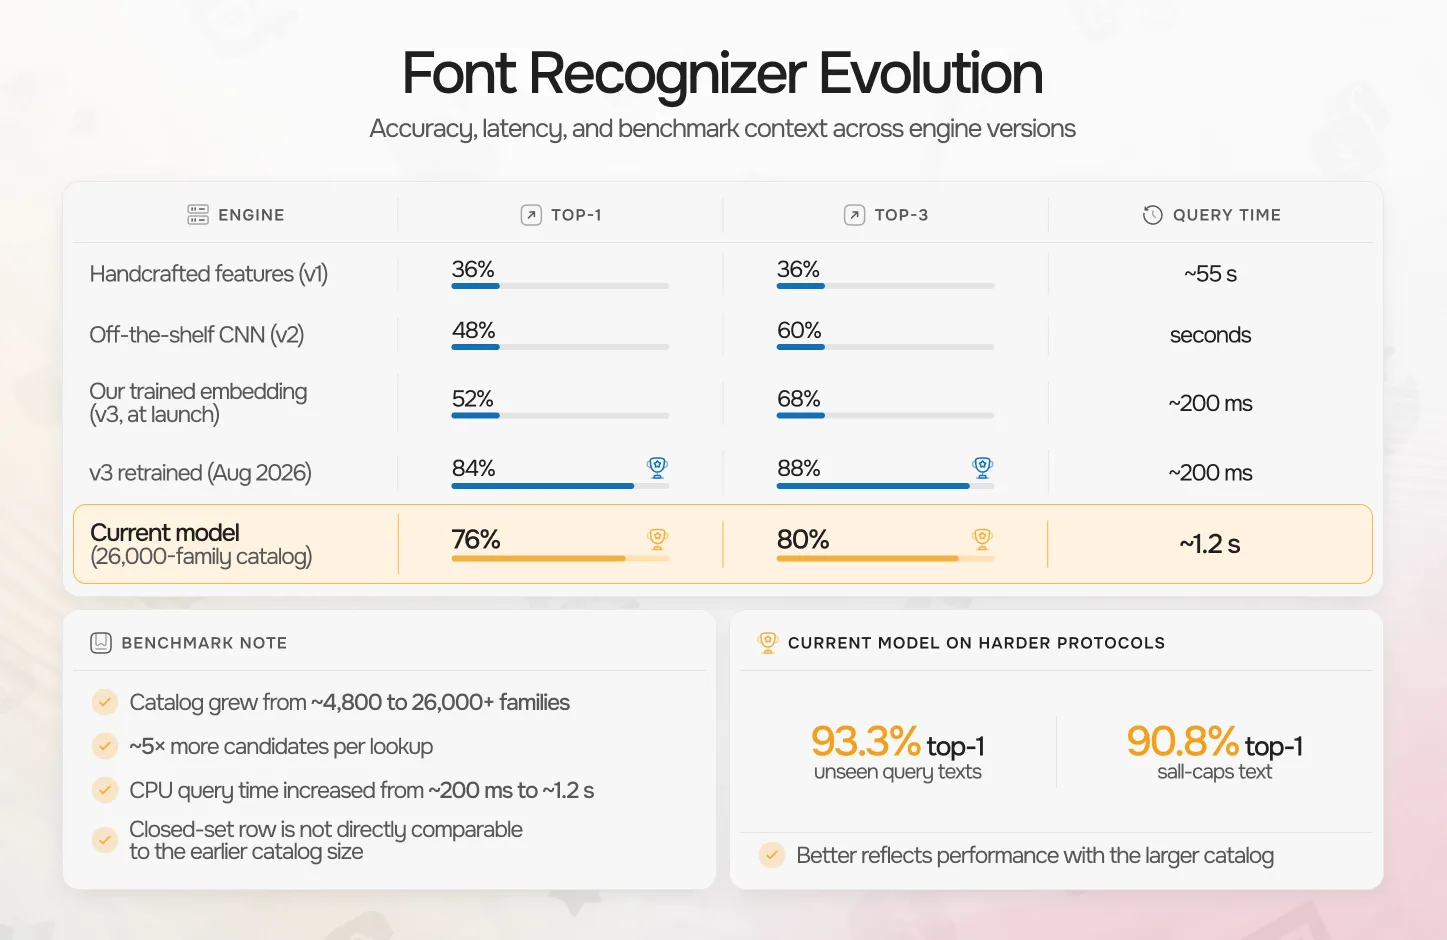
Avaliamos os três motores com um protocolo idêntico: o mesmo conjunto de fontes, as mesmas entradas degradadas que imitam capturas de tela, precisão no nível da família.
| Motor | Top-1 | Top-3 | Tempo de consulta |
|---|---|---|---|
| Características definidas à mão (v1) | 36% | 36% | ~55 s |
| CNN pronta (v2) | 48% | 60% | segundos |
| O nosso embedding treinado (v3, no lançamento) | 52% | 68% | ~200 ms |
| v3 retreinado (ago. 2026) | 84% | 88% | ~200 ms |
| Modelo atual (catálogo de 26.000 famílias) | 76% | 80% | ~1,2 s |
Duas coisas mudaram nessa última linha, e ambas foram intencionais. O catálogo cresceu de cerca de 4.800 famílias de fontes para mais de 26.000 — mais de cinco vezes maior —, e retreinamos o modelo do zero com tudo isso, usando uma rede maior e uma resolução de entrada mais alta. Cada busca agora é feita entre cinco vezes mais candidatas, e o tempo de consulta passou de ~200 ms para cerca de 1,2 segundo: o preço de um modelo mais pesado rodando em CPU.
A coluna de precisão nessa linha é fácil de ler como um retrocesso, então ela merece uma ressalva. Este benchmark é um conjunto fechado de 25 fontes, em que uma única fonte vale quatro pontos percentuais — e esse conjunto comum é tirado de um catálogo que agora é cinco vezes maior, então as duas últimas linhas não estão medindo a mesma tarefa. Nos protocolos que realmente conseguem distinguir os dois modelos — textos de consulta inéditos, com o catálogo inteiro atuando como distratores —, o modelo novo está muito à frente: 93,3% no top-1 contra 72,4%, e 90,8% contra 61,3% em texto todo em maiúsculas. Esses números estão no epílogo abaixo.
O que exatamente avaliamos?
Uma pergunta justa — números de precisão não significam nada sem o protocolo. O conjunto de teste tem 25 famílias de fontes presentes na cobertura dos três motores (uma restrição imposta pelo classificador pronto, que só conhece a sua lista fixa de classes). Para cada família, renderizamos uma amostra de texto e a passamos por um pipeline de degradação que imita capturas de tela: redução e ampliação em 3× (simulando texto pequeno na tela), leve desfoque, compressão JPEG com qualidade 45 e ruído de sensor — e então enviamos as mesmas imagens degradadas aos três motores, com uma semente aleatória fixa. A precisão é medida no nível da família: uma previsão conta como correta se nomeia a família certa, em qualquer estilo; o top-3 conta a família certa em qualquer posição entre os três primeiros resultados.
Observe que esses números vêm de entradas propositalmente degradadas — o benchmark simula capturas de tela ruins, porque essa é a vida real. O modelo retreinado praticamente não percebe a degradação: no nosso protocolo interno mais difícil (textos de consulta inéditos contra o catálogo completo de 15.000 fontes), a precisão top-1 dele é idêntica com entradas limpas e degradadas.
E o número do top-3 importa mais do que parece: na prática, você dá uma olhada em três candidatas com o seu próprio texto de prévia e escolhe a certa na hora. O motor v1 não conseguia oferecer isso de jeito nenhum — o modelo atual leva você até lá quase nove em cada dez vezes, mesmo com entradas ruins.
Um bônus que não planejamos: as mesmas impressões digitais agora alimentam a seção “Fontes semelhantes” em cada página de fonte do catálogo. Treine um modelo, ganhe dois recursos.
Como ele se compara a outros identificadores de fontes
Identificar fontes não é uma ideia nova, e algumas ferramentas consagradas fazem isso bem. Se você está à caça de uma fonte, aqui vai um mapa honesto do cenário:
- WhatTheFont (MyFonts) — provavelmente o mais conhecido, apoiado por uma enorme biblioteca comercial. Ótima cobertura do alfabeto latino; naturalmente, os resultados puxam para fontes que você pode comprar na MyFonts.
- WhatFontIs — um índice enorme que mistura fontes gratuitas e comerciais, com uma boa descoberta de fontes alternativas. Há um plano gratuito, enquanto buscas ilimitadas, prévias personalizadas e filtros avançados fazem parte do PRO.
- Fontspring Matcherator — limpo, rápido, sem cadastro, com filtragem por recursos OpenType. Focado no catálogo comercial da Fontspring.
- Font Squirrel Matcherator — da mesma família de motores do Fontspring, voltado para a biblioteca da Font Squirrel de fontes gratuitas para uso comercial.
- Identifont — o veterano do gênero: sem envio de imagem, apenas um questionário sobre as formas das letras (“o Q tem a cauda reta?”). Mais lento, mas surpreendentemente eficaz quando tudo o que você tem é a lembrança da fonte.
Onde o nosso se encaixa? Três coisas o destacam nesse grupo:
- O cirílico como cidadão de primeira classe — treinado com ele, indexado com ele, avaliado com ele. Para texto em ucraniano, essa é a diferença entre “funciona” e “chuta”.
- Prévia instantânea com o seu texto — cada candidata é renderizada de novo, ao vivo, com qualquer palavra que você digitar, o que transforma “as 3 melhores candidatas” em “a resposta” em segundos.
- Grátis, sem conta e com download — as correspondências levam direto às páginas das fontes no nosso catálogo, onde as próprias fontes podem ser baixadas e usadas gratuitamente.
Não vamos fingir que cobrimos mais do que a biblioteca comercial da MyFonts — se você está identificando uma fonte corporativa licenciada, o WhatTheFont pode dizer o nome exato da fonte comercial, enquanto nós mostramos as parentes mais próximas dela. Catálogos diferentes, pontos fortes diferentes. Para fontes gratuitas e para qualquer coisa em cirílico, colocaríamos o nosso identificador lado a lado com qualquer um deles.
Epílogo: depois deixamos o catálogo 7× maior — e retreinamos de novo
Este post estava quase pronto quando fizemos algo que mudou os números mais uma vez. Em uma única semana, expandimos o catálogo de ~5.000 para mais de 26.000 famílias publicadas (34.500 no total) e retreinamos o modelo do zero com a coleção completa — um backbone maior (EfficientNet-B2), resolução mais alta (288 px), cobertura completa de glifos, incluindo latino estendido e cirílico, amostragem com mais maiúsculas e amostragem dos eixos de fontes variáveis guiada pelas tabelas fvar reais das fontes.
Em um protocolo de avaliação com 900 famílias, o novo modelo identifica a família certa em 93,3% das vezes (98,7% no top-3), enquanto o anterior chegava a 72,4% — e em texto de pôster todo em maiúsculas, o caso real mais difícil, ele saltou de 61,3% para 90,8% no top-1. O identificador que você usa hoje roda esse modelo, apoiado por um índice de 278.000 renderizações e por uma etapa de reclassificação assistida por OCR que separa fontes quase idênticas com base no seu texto exato.
De um script artesanal de 55 segundos que acertava um terço das vezes a uma rede neural treinada por nós que identifica a fonte entre 26.000 famílias em cerca de um segundo — essa é a história até agora. E não será o último capítulo.
O que vem a seguir
O identificador não está parado. Duas coisas continuam a melhorá-lo, em dois ritmos diferentes:
- O catálogo cresce toda semana — e, graças à arquitetura de embeddings, cada nova família de fontes se torna reconhecível no momento em que a sua impressão digital é calculada e adicionada ao índice. Sem retreinamento, sem esperar pela próxima versão do modelo.
- O próprio modelo recebe atualizações periódicas. À medida que o catálogo cresce, crescem também os nossos dados de treinamento — cada nova família é mais material para a próxima rodada de treinamento. Nos planos: treinamento em resolução mais alta para distinguir melhor fontes decorativas e cursivas, cobertura de mais sistemas de escrita além do latino e do cirílico (grego e vietnamita primeiro) e consultas com vários recortes — reconhecer a fonte a partir de duas ou três amostras de uma vez e calcular a média das impressões digitais para uma correspondência mais estável.
Os números de precisão deste post são um retrato do momento, não um teto.
Experimente
O Identificador de fontes está no ar em jinero.online/pt/fonts/recognizer — grátis, sem cadastro, com suporte a latino e cirílico. Faça uma captura de tela de uma fonte que despertou a sua curiosidade e veja o que aparece.
Este é o primeiro post da nossa série de análises detalhadas das ferramentas. No próximo, vamos escolher outra ferramenta da coleção e desmontá-la do mesmo jeito. Se houver uma que você gostaria que abordássemos primeiro, fale conosco.
Comentários 0
Entre para ser o primeiro a comentar.