


Con este artículo empezamos algo que queríamos hacer desde hace tiempo, una serie de análisis a fondo de las herramientas de Jinero: qué hacen, cómo funcionan por dentro y la historia real de cómo nacieron, incluidos los enfoques que no sobrevivieron.
Empezamos por el  Identificador de fuentes, y no por casualidad. Es la herramienta con la historia de desarrollo más larga del sitio: pasó por tres motores completamente distintos, comparamos cada uno con los demás y terminamos entrenando nuestra propia red neuronal. Si alguna herramienta merece el primer artículo entre bastidores, es esta.
Qué hace
Has visto una fuente que te gusta (en un cartel, en una captura de pantalla, en la foto de un escaparate) y quieres saber cuál es. Ese es todo el caso de uso.
Subes la imagen, recortas la zona con el texto y el Identificador de fuentes te devuelve las coincidencias más cercanas de nuestro catálogo de más de 26.000 familias de fuentes (más de 55.000 estilos individuales). Cada coincidencia incluye una vista previa en vivo: escribe tu propia palabra y la verás al instante en cada fuente candidata. Es la forma más rápida de confirmar “sí, es esta”.
Tres cosas que conviene destacar:
- No hace falta escribir nada. No tienes que decirle a la herramienta qué dice el texto de la imagen. Se fija en la forma de las letras, no en las palabras.
- Lee cirílico. El soporte del cirílico suele ser menos visible, estar peor documentado y ser menos consistente en las herramientas de identificación de fuentes. Nuestro modelo se entrenó y se evaluó expresamente con el alfabeto latino y con el cirílico: una captura de un texto en ucraniano funciona igual de bien que una en inglés.
- Es gratis y sin registro. Recorta, identifica y descarga la fuente si está en nuestro catálogo.
Cómo funciona (la versión sencilla)
El reconocimiento moderno de fuentes no consiste en “leer” el texto. Nuestro motor convierte la imagen recortada en una huella numérica compacta, un embedding: un vector de 128 números que describe la forma de las letras (el contraste del trazo, los terminales, las proporciones, el esqueleto general de la fuente).
Cada fuente del catálogo ya tiene sus propias huellas, calculadas de antemano a partir de renderizados limpios y guardadas en un índice. Así, el reconocimiento es simplemente una búsqueda por similitud: se compara la huella de tu imagen con el índice y se devuelven las familias más cercanas. El trabajo pesado se hace una sola vez, por adelantado; tu consulta tarda una fracción de segundo.
Tuvimos que resolver bien algunos detalles prácticos:
- Normalización a oscuro sobre claro. El índice se construye con texto oscuro sobre fondo claro. Si tu captura está invertida (texto claro en un sitio oscuro), la herramienta lo detecta por el borde del recorte y la invierte antes de comparar.
- Un resultado por familia. La negrita y la regular de una misma fuente no deberían ocupar dos puestos en los resultados. Agrupamos a nivel de familia y mostramos el estilo que mejor coincide.
- Resistencia a capturas reales. Una foto algo borrosa y comprimida en JPEG no se parece en nada a un renderizado impecable de la fuente. El modelo se entrenó específicamente para ignorar esa diferencia (más sobre esto abajo).
La historia: tres motores, dos reescrituras
Intento 1: el motor artesanal
La primera versión funcionaba como lo haría un tipógrafo, si un tipógrafo fuera un script: usaba OCR para leer el texto de tu imagen, ampliaba el recorte con un modelo de superresolución (ESPCN), luego renderizaba ese mismo texto en cada fuente candidata y comparaba las imágenes con rasgos geométricos diseñados a mano (perfiles de proyección, medidas del trazo), con una pasada de reordenación encima.
Funcionaba. Más o menos. Dos problemas acabaron con él:
- Velocidad. Renderizar y comparar texto en miles de fuentes tardaba unos 55 segundos por consulta. Aceptable para una demo, un suplicio para una herramienta real.
- Un patrón frágil de “todo o nada”. La precisión top-1 era del 36%, y la top-3 también del 36%. Si la fuente correcta no era el primer resultado, no aparecía en la lista en absoluto. No había una lista útil de “coincidencias cercanas”, que es la mitad del valor de una herramienta así.
Además, dependía de que el OCR acertara. Las letras estilizadas, justo las que la gente más quiere identificar, son justo con las que peor funciona el OCR.
Intento 2: una red neuronal ya entrenada
Después probamos una CNN de clasificación de fuentes ya hecha (una EfficientNet-B3 entrenada por terceros con 3.473 clases de fuentes). Superó a nuestro motor artesanal, con un 48% top-1 y un 60% top-3, y además era rápida.
Pero un clasificador fijo tiene un techo infranqueable: solo puede nombrar las fuentes con las que se entrenó. Nuestro catálogo era más grande que su lista de clases, crecía cada semana e incluía familias cirílicas que el modelo nunca había visto. Cada nuevo lote de fuentes habría supuesto volver a entrenarlo. Eso no es un motor, es una cinta de correr.
Intento 3: nuestro propio modelo de embeddings
Así que entrenamos el nuestro: una EfficientNet-B0 compacta que convierte cualquier imagen de texto en esa huella de 128 números, entrenada con aprendizaje métrico sobre renderizados de nuestro propio catálogo, con alfabeto latino y cirílico a la vez.
El truco clave estaba en los datos de entrenamiento. No lo entrenamos solo con renderizados limpios: los degradamos a conciencia con desenfoque, ruido, artefactos de compresión JPEG, fondos tintados y ligeras rotaciones. El modelo aprendió que un renderizado nítido del catálogo y una foto mediocre de la misma fuente hecha con el teléfono deben dar la misma huella. Esa propiedad, la invariancia al renderizado, es lo que hace que funcione con capturas reales.
La arquitectura también resolvió el problema de la cinta de correr. Cuando llegan fuentes nuevas, no volvemos a entrenar nada: solo las renderizamos, calculamos sus huellas con el modelo existente y las añadimos al índice. El catálogo crece; el modelo se queda como está.
Y resolvió el problema de la velocidad para siempre. Como todo el trabajo pesado (renderizar el catálogo y calcular sus huellas) se hace por adelantado, una consulta en vivo es solo una inferencia de un modelo pequeño más una búsqueda por similitud. En nuestro hardware de producción, una pasada completa del motor tarda unos 200 ms (mediana de ~195 ms en ejecuciones repetidas, solo con CPU, sin GPU). El motor v1 necesitaba ~55 segundos para lo mismo: es aproximadamente 280 veces más rápido y, además, casi duplica la precisión top-3.
El mismo identificador también está disponible en nuestra  Fonts API pública (
POST /api/v1/fonts/recognize) para los desarrolladores que quieran identificar fuentes dentro de sus propios flujos de trabajo.
Los resultados
Evaluamos los tres motores con un protocolo idéntico: el mismo conjunto de fuentes, las mismas entradas degradadas como si fueran capturas de pantalla y precisión a nivel de familia.
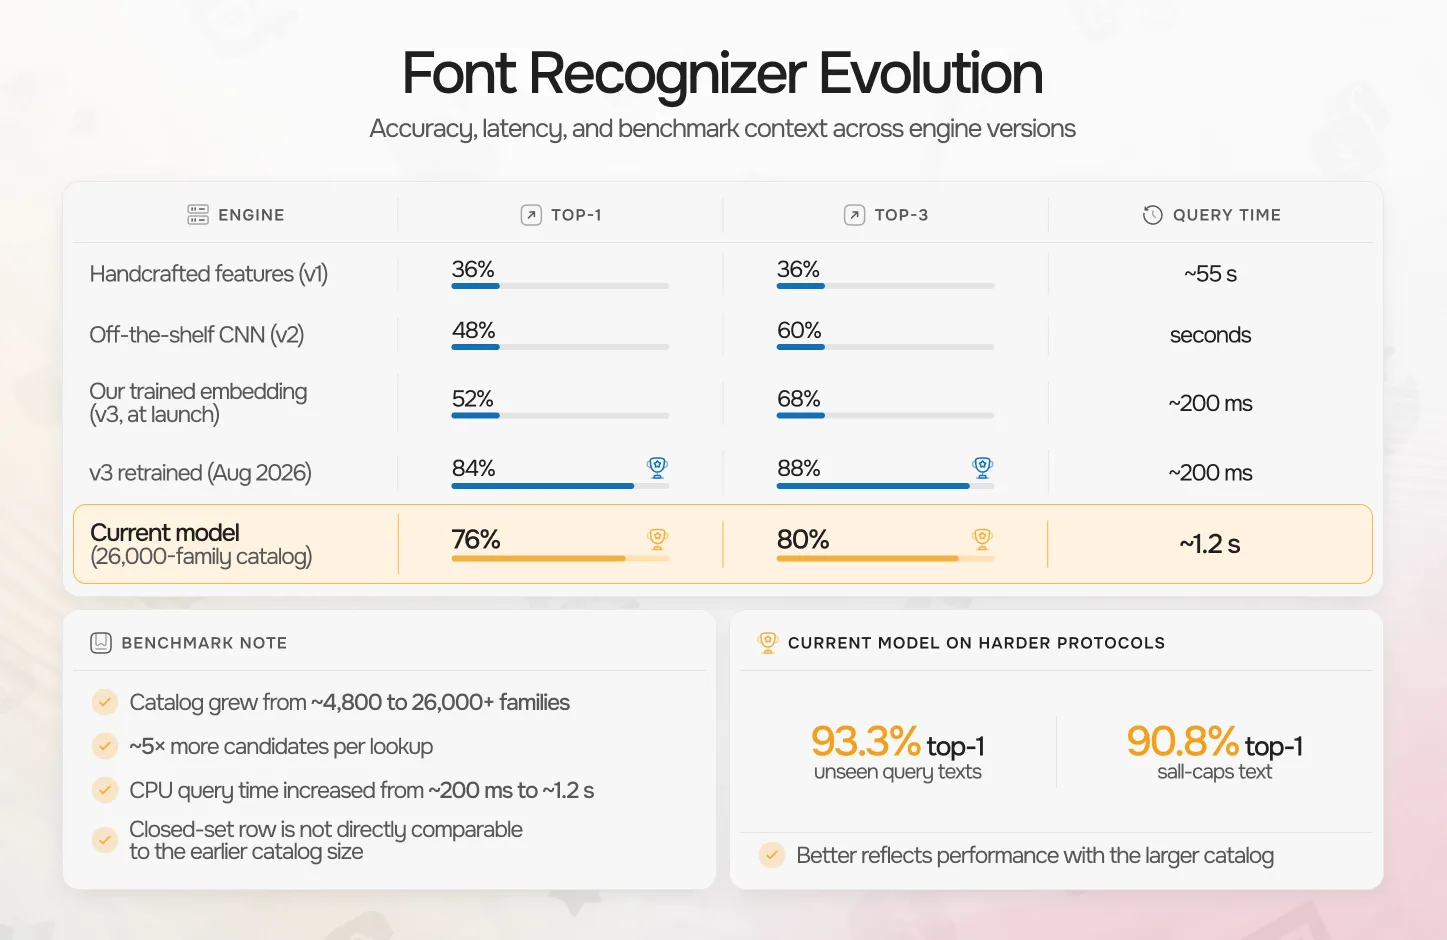
| Motor | Top-1 | Top-3 | Tiempo por consulta |
|---|---|---|---|
| Rasgos artesanales (v1) | 36% | 36% | ~55 s |
| CNN ya entrenada (v2) | 48% | 60% | segundos |
| Nuestro embedding entrenado (v3, en el lanzamiento) | 52% | 68% | ~200 ms |
| v3 reentrenado (ago. 2026) | 84% | 88% | ~200 ms |
| Modelo actual (catálogo de 26.000 familias) | 76% | 80% | ~1,2 s |
En esa última fila cambiaron dos cosas, y ambas fueron deliberadas. El catálogo pasó de unas 4.800 familias de fuentes a más de 26.000 (más de cinco veces más grande) y reentrenamos desde cero con todo él, con una red más grande y una resolución de entrada mayor. Ahora cada búsqueda compara con cinco veces más candidatas, y el tiempo por consulta pasó de ~200 ms a unos 1,2 segundos: el precio de un modelo más pesado en CPU.
La columna de precisión de esa fila se puede malinterpretar fácilmente como un paso atrás, así que merece una aclaración. Este benchmark es un conjunto cerrado de 25 fuentes, en el que una sola fuente vale cuatro puntos porcentuales, y ese conjunto común se extrae de un catálogo que ahora es cinco veces mayor, así que las dos últimas filas no miden la misma tarea. En los protocolos que de verdad distinguen ambos modelos (textos de consulta no vistos y todo el catálogo como distractor), el nuevo va muy por delante: 93,3% top-1 frente a 72,4%, y 90,8% frente a 61,3% con texto en mayúsculas. Esas cifras están en el epílogo, más abajo.
¿Qué medimos exactamente?
Es una pregunta justa: las cifras de precisión no significan nada sin el protocolo. El conjunto de prueba son 25 familias de fuentes que cubren los tres motores (una restricción impuesta por el clasificador ya entrenado, que solo conoce su lista fija de clases). Para cada familia renderizamos una muestra de texto y la pasamos por un proceso que la degrada como una captura de pantalla: reducción y ampliación ×3 (simula texto pequeño en pantalla), un ligero desenfoque, compresión JPEG con calidad 45 y ruido de sensor. Después dimos las mismas imágenes degradadas, idénticas, a los tres motores con una semilla aleatoria fija. La precisión se mide a nivel de familia: una predicción es correcta si nombra la familia correcta, en cualquier estilo; el top-3 cuenta la familia correcta en cualquiera de los tres primeros resultados.
Ten en cuenta que estas cifras salen de entradas degradadas a propósito: el benchmark simula malas capturas de pantalla, porque así es la vida real. El modelo reentrenado apenas nota la degradación: en nuestro protocolo interno más difícil (textos de consulta no vistos frente al catálogo completo de 15.000 fuentes), su precisión top-1 es idéntica con entradas limpias y degradadas.
Y la cifra top-3 importa más de lo que parece: en la práctica, echas un vistazo a tres candidatas con tu propio texto de vista previa y eliges la correcta al instante. El motor v1 no podía ofrecer eso en absoluto; el modelo actual te lleva hasta ahí casi nueve de cada diez veces, incluso con entradas de mala calidad.
Un extra que no habíamos planeado: esas mismas huellas alimentan ahora la sección “Fuentes similares” de cada página de fuente del catálogo. Entrenas un modelo y obtienes dos funciones.
Comparación con otros buscadores de fuentes
Identificar fuentes no es una idea nueva, y algunas herramientas consolidadas lo hacen bien. Si buscas una fuente, este es un mapa honesto del panorama:
- WhatTheFont (MyFonts): probablemente la más conocida, respaldada por una enorme biblioteca comercial. Muy buena cobertura del alfabeto latino; como es lógico, los resultados tienden hacia fuentes que puedes comprar en MyFonts.
- WhatFontIs: un índice enorme que mezcla fuentes gratuitas y comerciales, muy útil para descubrir alternativas. Tiene un plan gratuito, mientras que las búsquedas ilimitadas, las vistas previas personalizadas y los filtros avanzados forman parte de PRO.
- Fontspring Matcherator: limpio, rápido, sin registro y con filtros por funciones OpenType. Centrado en el catálogo comercial de Fontspring.
- Font Squirrel Matcherator: de la misma familia de motores que el de Fontspring, orientado a la biblioteca de Font Squirrel de fuentes gratuitas para uso comercial.
- Identifont: el veterano del género. No se sube ninguna imagen, solo se responde un cuestionario sobre la forma de las letras (“¿la Q tiene la cola recta?”). Es más lento, pero sorprendentemente eficaz cuando lo único que tienes es el recuerdo de la fuente.
¿Dónde encaja el nuestro? Tres cosas lo distinguen en esta compañía:
- El cirílico, ciudadano de primera clase: entrenado con él, indexado con él, evaluado con él. Para un texto en ucraniano, es la diferencia entre “funciona” y “adivina”.
- Vista previa instantánea con tu texto: cada candidata se vuelve a renderizar en vivo con la palabra que escribas, lo que convierte “las tres mejores candidatas” en “la respuesta” en segundos.
- Gratis, sin cuenta y con descarga: las coincidencias enlazan directamente a las páginas de las fuentes en nuestro catálogo, donde puedes descargarlas y usarlas gratis.
No vamos a fingir que cubrimos más que la biblioteca comercial de MyFonts: si estás identificando una fuente corporativa con licencia, puede que WhatTheFont dé con la fuente comercial exacta mientras nosotros te mostramos sus parientes más cercanos. Catálogos distintos, puntos fuertes distintos. Para fuentes gratuitas, y para todo lo que sea cirílico, pondríamos nuestro identificador a competir con cualquiera de ellos.
Epílogo: luego hicimos el catálogo 7 veces más grande — y volvimos a entrenar
Este artículo estaba casi terminado cuando hicimos algo que volvió a cambiar las cifras. En una sola semana ampliamos el catálogo de ~5.000 a más de 26.000 familias publicadas (34.500 en total) y reentrenamos el modelo desde cero con la colección completa: una red base más grande (EfficientNet-B2), mayor resolución (288 px), cobertura completa de glifos (incluidos el latino y el cirílico extendidos), un muestreo con más peso de las mayúsculas y un muestreo de los ejes de las fuentes variables a partir de sus tablas fvar reales.
En un protocolo de evaluación con 900 familias, el nuevo modelo identifica la familia correcta el 93,3% de las veces (98,7% en el top-3), frente al 72,4% del anterior; y con texto de cartel en mayúsculas, el caso real más difícil, pasó del 61,3% al 90,8% en top-1. El identificador que usas hoy funciona con este modelo, respaldado por un índice de 278.000 renderizados y una etapa de reordenación asistida por OCR que distingue fuentes casi idénticas sobre tu texto exacto.
De un script artesanal de 55 segundos que acertaba una de cada tres veces a una red neuronal entrenada por nosotros que reconoce entre 26.000 familias en un segundo aproximadamente: esa es toda la historia hasta ahora. Y no será el último capítulo.
Qué viene después
El identificador no está congelado. Dos cosas lo siguen mejorando, a dos ritmos distintos:
- El catálogo crece cada semana, y gracias a la arquitectura de embeddings, cada nueva familia de fuentes se puede reconocer en cuanto se calcula su huella y se añade al índice. Sin reentrenar y sin esperar a la próxima versión del modelo.
- El propio modelo recibe mejoras periódicas. A medida que crece el catálogo, crecen también nuestros datos de entrenamiento: cada nueva familia es más material para el siguiente entrenamiento. En la hoja de ruta: entrenamiento con mayor resolución para distinguir mejor las fuentes decorativas y caligráficas, más sistemas de escritura además del latino y el cirílico (primero el griego y el vietnamita) y consultas con varios recortes, es decir, reconocer a partir de dos o tres muestras de la misma fuente a la vez y promediar sus huellas para lograr una coincidencia más estable.
Las cifras de precisión de este artículo son una instantánea, no un techo.
Pruébalo
El Identificador de fuentes ya está disponible en jinero.online/es/fonts/recognizer: gratis, sin registro, para alfabeto latino y cirílico. Haz una captura de esa fuente que te ha despertado la curiosidad y mira qué resultados obtienes.
Este es el primer artículo de nuestra serie de análisis a fondo de herramientas. En el próximo elegiremos otra herramienta de la colección y la desmontaremos de la misma manera. Si hay alguna que te gustaría que tratáramos primero, cuéntanoslo.
Comentarios 0
Inicia sesión para dejar el primer comentario.